
正在加载,请稍候
Figma 工程团队用自建智能体处理安全告警,复杂告警处理时间缩短约 70%。拆解数据源、检索、记忆分层与控制四层结构,以及 AI Agent 开发中最容易被忽略的降级风险。
凌晨三点被叫醒的安全值班工程师,前二十分钟往往不是在分析攻击,而是打开 Slack 往上翻通话记录,再去工单里搜「这个 IP 上周出现过吗」。Figma 工程团队把这段重复劳动交给了一套自建智能体系统:复杂告警处理时间缩短约 70%,值班通知减少 20%。对正在做 AI Agent 开发的企业团队而言,这个案例值得看的不是模型选型,而是它前后四层的结构。
安全工程师 Matthew Sullivan 与安全工程经理 Brad Girardeau 在 Figma 官方博客里复盘了这套系统。他们给出的问题定义很朴素:值班工程师处理一条告警,要重复做四件事——翻完整的对话记录、检索历史事件、检查公司内部系统、最后动手写修复代码。
这四件事的共同点是信息都在,但散在四个地方。人做起来不算慢,慢在来回切换上下文,以及每次都要重新建立判断依据。
据 InfoQ 2026 年 9 月 13 日的编译报道,这套系统最终把复杂告警的处理时间压掉约七成,同时让值班通知量下降两成。
系统建在 Panther SIEM 之上,负责调查告警并检查 AWS、Okta、GitHub、GCP 的审计日志,另外还接入 osquery 采集的终端系统信息。
osquery 这个选择值得留意:它允许用 SQL 查询机器的安全与系统状态,于是终端信息不是以日志行的形式进入系统,而是以可查询的表形式进入。除这些来源之外,系统还会查询另外 100 多个数据源。
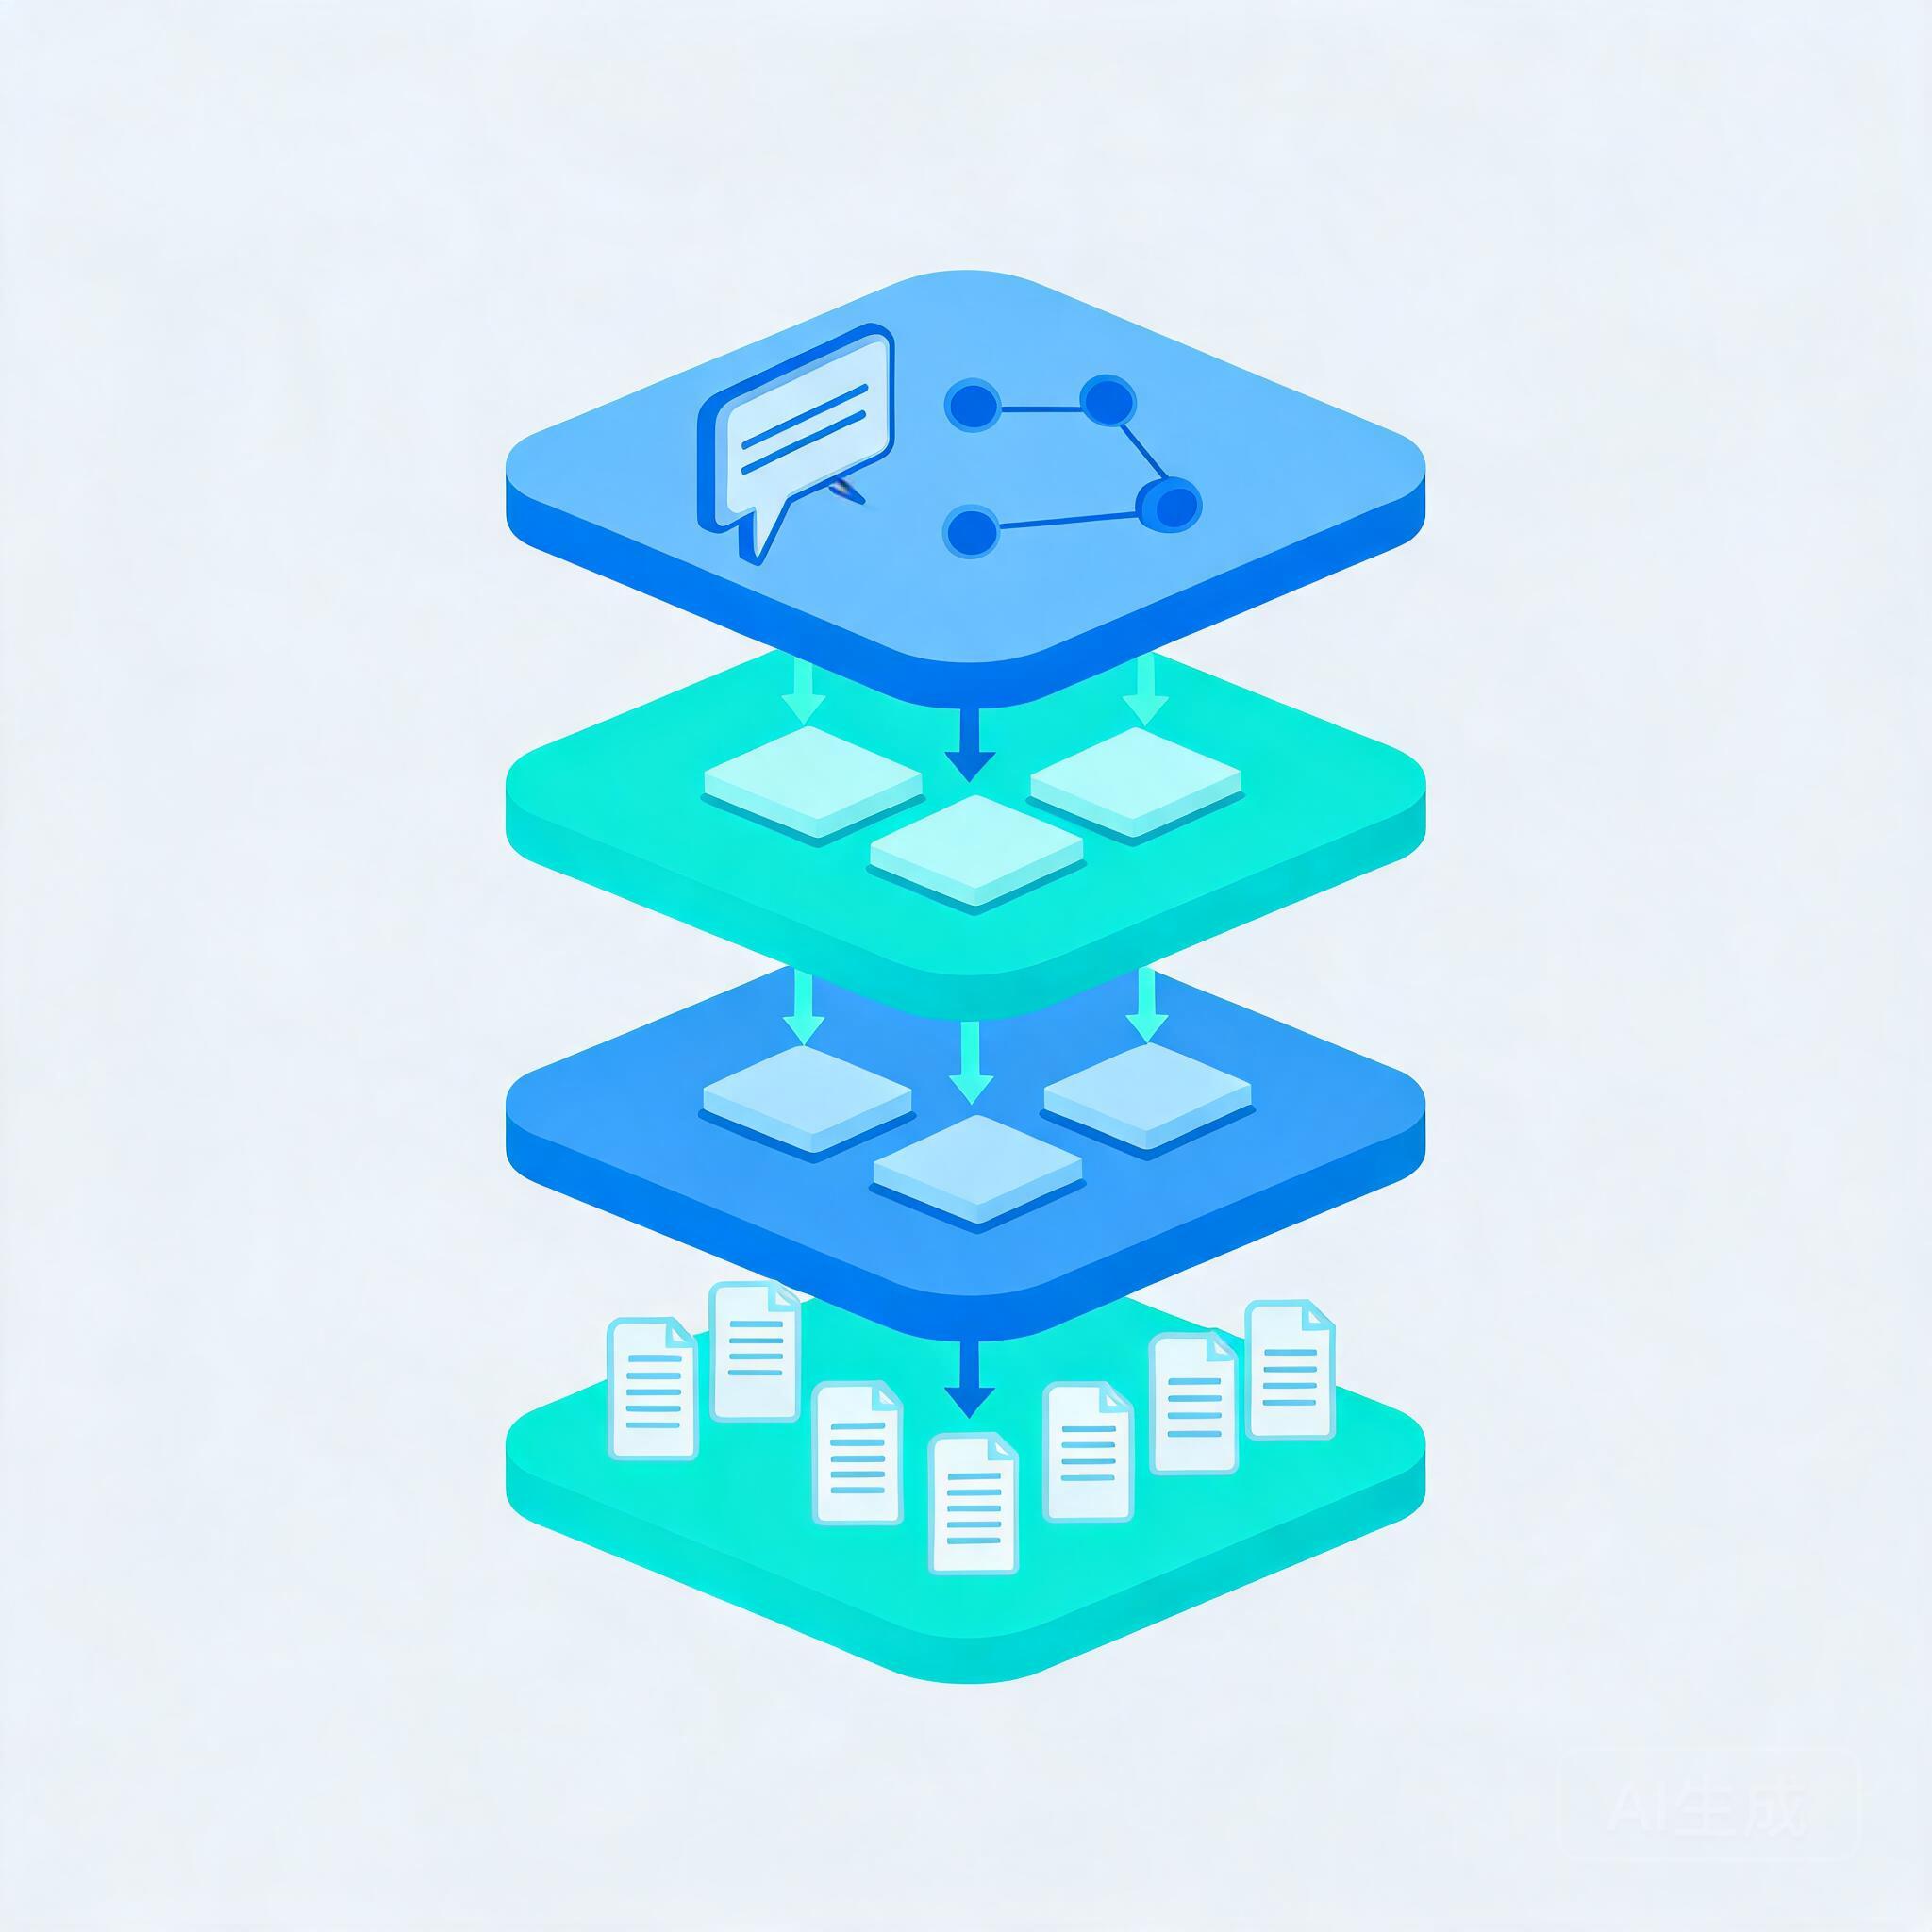
这一层的工程量最大,也最不容易出彩。可是没有统一可查询的数据面,后面三层全是空谈。
该团队没有用一个向量库打天下,而是按问题类型分了四条检索路径。
分工逻辑很清楚:历史告警是结构化记录,用 SQL 查比用向量检索准;文档类是半结构化知识,才交给语义检索。把这两类问题塞进同一个索引,是很多团队第一次做安全智能体时踩的坑。
承担大部分调查工作的是「告警分诊代理」,它采用类似 Claude Opus 的模型,输入是完整的对话记录加上自身的引导记忆,再配一套值班工程师日常使用的工具集。
该团队的原话是:记忆是这个系统随时间变得越来越有用的关键因素,而把多种记忆分开管理「被证明至关重要」。他们把记忆分成三类。
| 记忆类型 | 存什么 | 更新方式 |
|---|---|---|
| 历史告警 | 过往事件的调查过程与结论 | 随新告警自动写入 |
| 行为指南 | 团队对「什么算正常」的判断标准 | 需要人工确认后更新 |
| 已习得的库结构 | 数据源的表结构与字段含义 | 随基础设施变化而更新 |
分开的理由是更新频率和权威性不同。历史记录每天新增,可以放心自动写入;行为指南代表团队判断,必须有人把关;库结构一错,所有查询都会失准。三者混在一个库里,一次错误写入就可能同时污染检索、判断和查询三类行为。
如果要把这三类记忆落到具体的存储与淘汰策略上,我们在智能体记忆工程的三层持久化架构里做过一组实现对照。
三个控制点都长在系统结构里,不靠模型自觉:安全控制内置于工具本身,代理能调用的动作被工具层限制;生成的拉取请求默认为草稿态,不会直接进入合并队列;提示词设计上防止敏感数据出现在公共频道。人工审核被完整保留。
边界仍在移动。同篇报道提到,云安全公司 Wiz 在《GhostApproval》报告中指出有六款 AI 编码助手可被恶意代码库欺骗,向用户展示看似无害的审批提示;InfoQ 此前也报道过 OpenAI 披露的沙箱逃逸问题。该团队自己的态度是:现有代理不完美,人类也不完美,这不是二选一。
草稿态产物加人工复核这套组合,另一个团队的 PR 边界口径可以放在一起看,两者对「哪些动作必须留给人」的切分点并不相同。
在《如何借助智能代理跑赢漏洞》一文里,他们给出了第二组数字:代理发现 100 多个此前未发现的漏洞,其中两个高危漏洞被传统工具遗漏;代码审查系统准确率在一个月内达到 80%;通过第二轮审查步骤,已知漏洞检出率提高约 30%;加入自动化指导后,部分编码错误减少约 50%。
团队给出的方法论排序值得记下来:先提高精确率,再提高召回率。这个顺序违反直觉,因为历史漏洞只能衡量召回率,对精确率几乎没有帮助,但他们认为精确率必须先行。误报率和门禁阈值怎么定,按类别采纳率的实测数据给了一组可参照的参数。
同期谷歌开源的 Mantis 走了同一条路。2026 年 9 月 12 日的报道提到,谷歌设计这套框架的起因正是 AI 代码扫描的真阳性率低于 7%;它用批评者、审查者、策略师、研究者四类代理配合沙箱化漏洞重现做闭环验证,并用分层树结构建模代码库,把令牌消耗降低 85%。
这套系统压缩处理时间的手段之一,是降低部分告警的严重级别。这一步最容易做错。
如果团队把降级做成静默——告警被自动降级、值班通知消失、过程没有留痕——那么团队失去的不是工作量,而是对漏报的感知能力。半年之后,没人说得清哪些告警被降过、依据是什么、有没有因此漏掉真实事件。
谷歌在 Mantis 上的提醒指向同一个风险:不要把低风险发现自动归类为误报,过于宽泛的反向过滤器会削弱系统检测真实漏洞的能力。降级动作必须可审计、可回溯、可撤销,否则它只是把运维成本换成了风险成本。
该团队自己提醒过,具体做法取决于公司规模、面临的风险和现有反馈机制,无法直接照搬。把四层结构当参考框架,具体阈值要用自家告警数据重新标定。跨天任务的四道工程门槛讨论的护栏层次,可以作为这套框架在长任务场景下的补丁。
脚本按固定规则触发固定动作;智能体接收对话上下文与记忆,自主决定调用哪个工具、查哪个数据源,并产出草稿态修复代码。差别不在「自动」,而在于按上下文决定下一步。
三类记忆的更新频率和权威性不同:历史记录可自动写入,行为指南需要人工确认,库结构随环境变化。混存会让一次错误写入同时污染检索、判断和查询三类行为。
这个数字来自该团队对自身复杂告警的统计,口径与数据源规模绑定。要复现,前提是数据面已经统一可查询;如果日志仍要在十几个控制台之间手工翻,瓶颈就不在代理身上。
这是该团队自述一个月内达到的水平,且配合了第二轮审查步骤——已知漏洞检出率因此提高约 30%。它不是通用水准,评估时应先看精确率再看召回率。
如果你正在评估把智能体接进自家安全或运维流程,可以从已交付的 AI Agent 开发项目里看我们如何处理数据面统一与人工审核边界这两个最容易失控的环节。